llms.txt в 2026: работает ли файл для ИИ, данные и как настроить
Вокруг llms.txt сложились два лагеря. Одни продают его как пропуск в ответы ChatGPT и Алисы, другие называют вторым мета-тегом keywords, который никто не читает. Правда лежит посередине и хорошо видна в цифрах. На попадание в ИИ-выдачу файл сегодня почти не влияет, зато у него есть узкая и вполне реальная аудитория — ИИ-агенты и ассистенты для разработчиков. Ниже разбираем, что известно о llms.txt на октябрь 2026 года, кто его действительно запрашивает и как собрать файл так, чтобы он не навредил сайту.
Что такое llms.txt и откуда он взялся
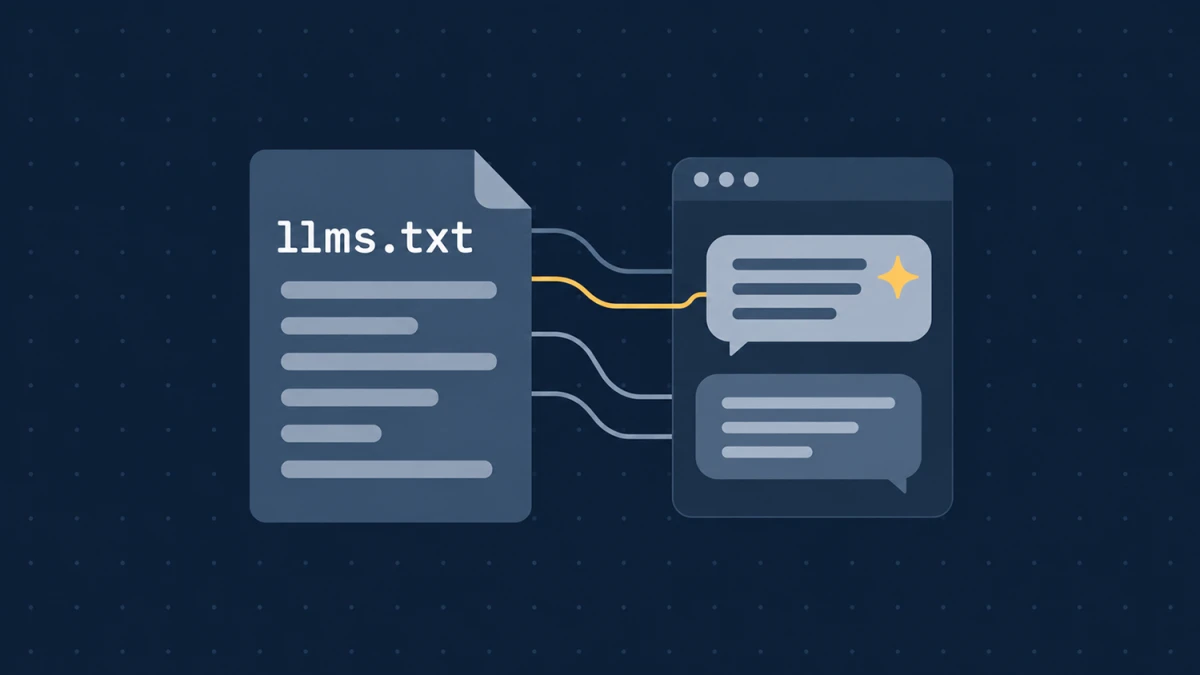
Формат предложил Джереми Ховард, сооснователь Answer.AI, 3 сентября 2024 года. Идея в том, чтобы положить в корень сайта Markdown-файл /llms.txt с кратким описанием проекта и списком ссылок на самые полезные страницы. Языковой модели проще прочитать такое оглавление, чем разбирать HTML с меню, баннерами и скриптами.
По спецификации с llmstxt.org обязательный элемент у llms.txt один — заголовок H1 с названием сайта. Дальше идут:
- Цитата-резюме. Блок
>с кратким описанием проекта, его настоятельно рекомендуют. - Пояснения. Обычные абзацы и списки с важными оговорками.
- Разделы со ссылками. Заголовки H2, под ними списки вида
[название](url): пояснение. - Раздел Optional. Второстепенные ссылки, которые можно пропустить.
Файла llms-full.txt в спецификации нет. Это соглашение, которое распространили платформы документации вроде Mintlify: в него складывают полный текст материалов одним документом, чтобы агент забрал всё за один запрос.
10 августа 2026 года вышла вторая редакция спецификации llms.txt. Автор переписал её с учётом двух лет практики. В v2 появились стандартные ссылки для поиска файла и Markdown-версий страниц (rel="describedby" и rel="alternate" type="text/markdown"), правило для файлов в подпапках («действует самый близкий к странице файл») и новое описание того, как агенты пользуются llms.txt. Они просматривают или ищут по нему нужное, а потом переходят по ссылкам. Раздел Optional потерял особый технический смысл и остался обычной договорённостью.
Позиция Google и разработчиков ИИ по llms.txt
Google высказывался про llms.txt несколько раз, и всегда сдержанно. Гэри Иллиес на Search Central Live заявил, что компания не поддерживает формат и не собирается его поддерживать. Джон Мюллер сравнивал llms.txt с мета-тегом keywords и писал, что ни один ИИ-сервис не объявлял об использовании файла, а по логам видно, что боты его даже не запрашивают. В июне 2026 года он повторил, что всё это «пока чистые спекуляции».
15 мая 2026 года Google опубликовал официальное руководство по оптимизации под генеративный поиск. В нём прямо сказано, что для появления в ИИ-ответах не нужны машиночитаемые файлы, отдельная разметка или Markdown-версии страниц, а такие файлы Google может обходить без особого к ним отношения.
При этом за неделю до руководства, 7 мая, вышел Chrome Lighthouse 13.3 с новой категорией Agentic Browsing. В ней есть проверка llms.txt — Lighthouse смотрит, лежит ли в корне домена машиночитаемое резюме сайта и отдаётся ли оно без ошибок сервера. Получилось, что Google Поиск говорит «не нужно», а инструмент Chrome для веб-разработчиков проверяет наличие файла. Противоречия тут меньше, чем кажется. Поиску llms.txt действительно не нужен, а Lighthouse оценивает готовность сайта к работе с ИИ-агентами, которые ходят по страницам от имени пользователя.
OpenAI, Anthropic, Perplexity и Meta публично не обещали использовать llms.txt как сигнал для поиска или цитирования. Anthropic, Google и многие другие компании при этом сами публикуют llms.txt для своей документации для разработчиков. Яндекс официальной поддержки формата не заявлял, а для видимости в Алисе предлагает собственные инструменты Вебмастера.
Что показывают логи серверов
Самое крупное исследование llms.txt провёл Ahrefs. Компания проверила 137 210 доменов, подключённых к её веб-аналитике, и в июне 2026 года опубликовала данные за май.
- Распространённость. Рабочий llms.txt нашёлся у 28% доменов, это 38 360 сайтов. Выборка смещена к технически подкованным проектам, по всему интернету доля ниже.
- Обращения. 97% файлов за месяц не получили ни одного запроса.
- Кто читает. Среди оставшихся 3% лидировали SEO-аудиторы, неопознанные боты и сервисы технической разведки. На все ИИ-системы пришлось 19,5% запросов, на поисковых ботов, которые подбирают источники для ответов, — около 1%.
- Отсутствующие файлы. Ни один ИИ-бот не пытался запросить llms.txt на сайтах, где его нет. Значит, специально такой файл никто не ищет.
Вывод Ahrefs сформулирован жёстко: если цель — появляться в ChatGPT, Perplexity или AI Overviews, llms.txt по большей части декорация.
SE Ranking ещё в ноябре 2025 года проверил около 300 000 доменов и сравнил наличие llms.txt с частотой цитирования в ответах нейросетей. Файл нашёлся у 10,13% сайтов, связи с цитированием статистика не показала. Более того, когда исследователи убрали признак llms.txt из модели машинного обучения, её точность выросла. Для предсказания видимости в ИИ-ответах этот фактор оказался шумом.
Где llms.txt действительно работает
У llms.txt есть сценарий, в котором он полезен уже сейчас. Это ИИ-агенты, которых пользователь сам направил на сайт. В логах Ahrefs среди заметных клиентов есть Claude-Code, а ассистенты для программирования вроде Cursor, Cline и Continue умеют подтягивать документацию через llms.txt, когда разработчик подключает её вручную или через MCP-сервер.
Отсюда понятно, кому файл приносит пользу:
- Документация и базы знаний. API, SDK, справка по модулям и шаблонам. Разработчик даёт агенту ссылку, агент читает оглавление и забирает нужные страницы в Markdown.
- Каталоги расширений и сервисов. Агенту, который подбирает модуль или сравнивает тарифы, проще пройти по чистому списку ссылок, чем по вёрстке.
- Сайты с большим объёмом справочного контента. Инструкции, FAQ, техописания товаров, которые пользователь может попросить ассистента изучить.
Для обычного блога, интернет-магазина или сайта услуг польза от llms.txt пока косвенная. Позиций в Google и Яндексе он не добавит, трафика из ChatGPT тоже. Зато сайт пройдёт проверку Lighthouse в категории Agentic Browsing и будет готов к агентам, которые начнут читать llms.txt, если формат закрепится.
Стоит ли тратить на llms.txt время
Ответ зависит от того, сколько времени уходит. Сам по себе файл безвреден, если в нём нет ошибок и устаревших ссылок. Проблемы начинаются, когда llms.txt собирают руками один раз, а потом забывают. Через полгода в нём половина ссылок ведёт на удалённые страницы, описания не совпадают с сайтом, а агент, который всё-таки зашёл, получает неверную картину.
Поэтому рекомендация Ahrefs звучит практично — пусть файл генерирует платформа сайта. Автоматическая сборка снимает почти все риски. Оглавление обновляется вместе с контентом, а вебмастер не тратит на формат ни часа сверх установки.
Если llms.txt приходится поддерживать вручную, стоит сначала заглянуть в логи сервера и посмотреть, запрашивает ли его кто-нибудь вообще. Для большинства сайтов честный ответ — почти никто.
Как собрать llms.txt по спецификации v2
Если файл делать, то по правилам. Вот практики, которые следуют из спецификации и наблюдений за реальными сайтами.
- Кодировка и тип. UTF-8 без лишних символов, ответ 200 по адресу
/llms.txt, типtext/plainилиtext/markdown. Lighthouse отдельно отмечает ошибки сервера при загрузке файла. - Короткое резюме. В блоке
>одним-двумя предложениями сказано, что это за сайт и для кого. Без рекламных формулировок. - Отбор ссылок. Главные разделы, ключевые страницы и свежие материалы. Копия sitemap.xml в Markdown — плохой llms.txt, агенту нужен путеводитель, а полный список URL у него уже есть.
- Пояснения к ссылкам. После двоеточия — что именно лежит на странице. Для агента это главный ориентир при выборе.
- Markdown-версии страниц. По v2 их можно отдавать по адресу с
.mdна конце и указывать в HTML через<link rel="alternate" type="text/markdown">. - Ссылка на сам файл.
<link rel="describedby" href="/llms.txt">в шапке сайта помогает агенту найти оглавление. Ahrefs советует также ссылаться на llms.txt из документации — агенты читают его, когда их туда направили. - Только публичный контент. В файл не должны попадать закрытые разделы, черновики, страницы для зарегистрированных.
- Контроль изменений. Ahrefs зафиксировал попытки промпт-инъекций через llms.txt. Файл стоит хранить как код — с резервными копиями и ограниченным доступом на запись.
- robots.txt отдельно. llms.txt ничего не запрещает и не разрешает. Доступ ботов вроде GPTBot, ClaudeBot или PerplexityBot по-прежнему управляется через robots.txt, и если бот там закрыт, оглавление ему не поможет.
Пример минимального llms.txt для сайта на InstantCMS:
# Мастерская ремонта «Пример»

> Сайт о ремонте квартир в Москве: инструкции, сметы, обзоры материалов и каталог мастеров.

Цены в сметах указаны на дату публикации и могут меняться.

## Главные страницы

- [О компании](https://example.ru/about.md): кто мы, гарантии, контакты
- [Каталог мастеров](https://example.ru/masters.md): мастера по видам работ и районам

## Статьи

- [Как выбрать ламинат для кухни](https://example.ru/articles/laminat-kuhnya.md): классы износостойкости и влагостойкость
- [Смета на ремонт ванной](https://example.ru/articles/smeta-vannaya.md): из чего складывается стоимость

## Optional

- [Новости компании](https://example.ru/news.md): акции и изменения графикаТипичные ошибки в llms.txt
- Вечный файл. Собран при запуске сайта и ни разу не обновлялся.
- Свалка ссылок. Тысячи URL без пояснений, в том числе теги, пагинация и служебные страницы.
- Перенасыщение ключами. Описания, написанные для поисковика. Агент читает смысл, ключевые слова его не впечатляют.
- Расхождение с сайтом. Цены, условия или описания в файле отличаются от страниц. Для ИИ-ассистента это источник неверного ответа.
- Ставка на позиции. Ожидание, что после загрузки llms.txt сайт поднимется в выдаче. Этого не произойдёт.
Что влияет на попадание в ответы нейросетей
Раз llms.txt почти не участвует в выборе источников, стоит понимать, что участвует. Google в своём руководстве прямо называет основой обычную SEO-работу, и исследования цитирования это подтверждают. ИИ-поиск чаще берёт страницы, которые уже хорошо видны в классической выдаче.
- Доступность для ботов. Страница индексируется, не закрыта в robots.txt, быстро отдаёт контент без обязательного JavaScript.
- Прямые ответы. Каждый раздел текста начинается с ясного ответа на свой вопрос и называет предмет по имени, без «он» и «этот сервис» вместо названия.
- Структура. Логичные подзаголовки, списки, таблицы для сравнений, FAQ.
- Факты и даты. Цифры с источниками, дата актуальности, автор. Устаревший текст ИИ цитирует реже.
- Микроразметка. Article, Product, Organization, BreadcrumbList по реальному содержимому страницы.
- Упоминания вне сайта. Обсуждения на форумах, отзывы, публикации на отраслевых площадках. ИИ-ответы строятся из многих источников, и бренд, о котором пишут другие, попадает в них заметно чаще.
llms.txt в этом списке — приятное дополнение для агентов, но фундамент видимости строится из пунктов выше.
Генератор llms.txt для InstantCMS
Для сайтов на InstantCMS 2 мы сделали бесплатный компонент Генератор llms.txt. Он закрывает главный риск формата — устаревание — и собирает файлы по спецификации llmstxt.org без ручной работы.
- Два файла.
llms.txtс названием и описанием сайта, главными страницами, свежими записями каждого типа контента и категориями. Иllms-full.txtс полными текстами материалов в Markdown и метаданными. - Автообновление. После публикации, правки, удаления или восстановления записи планировщик InstantCMS пересобирает файлы в течение 15 минут.
- Чистый Markdown. Заголовки, списки, таблицы, код и цитаты сохраняются при конвертации.
- Только публичный контент. Генератор видит сайт глазами гостя, закрытые записи в файлы не попадают.
- Проверки в админке. Валидация UTF-8 и проверка robots.txt для 12 ИИ-ботов, чтобы файл не оказался бесполезным из-за закрытого доступа.
- Резервные копии. Перед пересборкой сохраняется предыдущая версия файлов.
Компонент работает на InstantCMS 2.18.2, PHP 7.4 и 8.1–8.4, требует расширения DOM и curl, права на запись в корень сайта и настроенный cron. Позиций в поиске он не поднимает, и мы честно пишем об этом в описании. Его задача в том, чтобы llms.txt на вашем сайте был всегда актуальным и не отнимал времени.
Влияет ли llms.txt на позиции в Google и Яндексе?
Нет. Google прямо указал, что файл не нужен для появления в генеративном поиске, Яндекс поддержку формата не объявлял.
Помогает ли llms.txt попасть в ответы ChatGPT или Perplexity?
По данным SE Ranking (около 300 000 доменов) и Ahrefs (137 210 доменов), связи с цитированием нет, а поисковые ИИ-боты запрашивают файл крайне редко.
Кто тогда читает llms.txt?
SEO-аудиторы, сервисы анализа сайтов и ИИ-агенты, которых пользователь направил на сайт, например ассистенты для программирования, работающие с документацией.
Чем llms.txt отличается от robots.txt и sitemap.xml?
robots.txt управляет доступом ботов, sitemap.xml перечисляет страницы для индексации. llms.txt — путеводитель с пояснениями для языковых моделей, он ничего не разрешает и не запрещает.
Нужен ли llms-full.txt?
В спецификации его нет, это соглашение платформ документации. Он полезен, если агенту нужно забрать содержимое сайта целиком одним запросом.
Может ли llms.txt навредить сайту?
Сам по себе нет. Вредят устаревшие ссылки, расхождения с сайтом и попадание в файл закрытого контента, поэтому файл лучше генерировать автоматически.